
RSI 是遞迴自我改進:AI 改善自己的能力,再用提升後的能力推動下一輪改進。用學生學習的比喻,理解它與重寫答案、AI Agent 的差別,以及實際進展與限制。
 作者:Frank Chiu
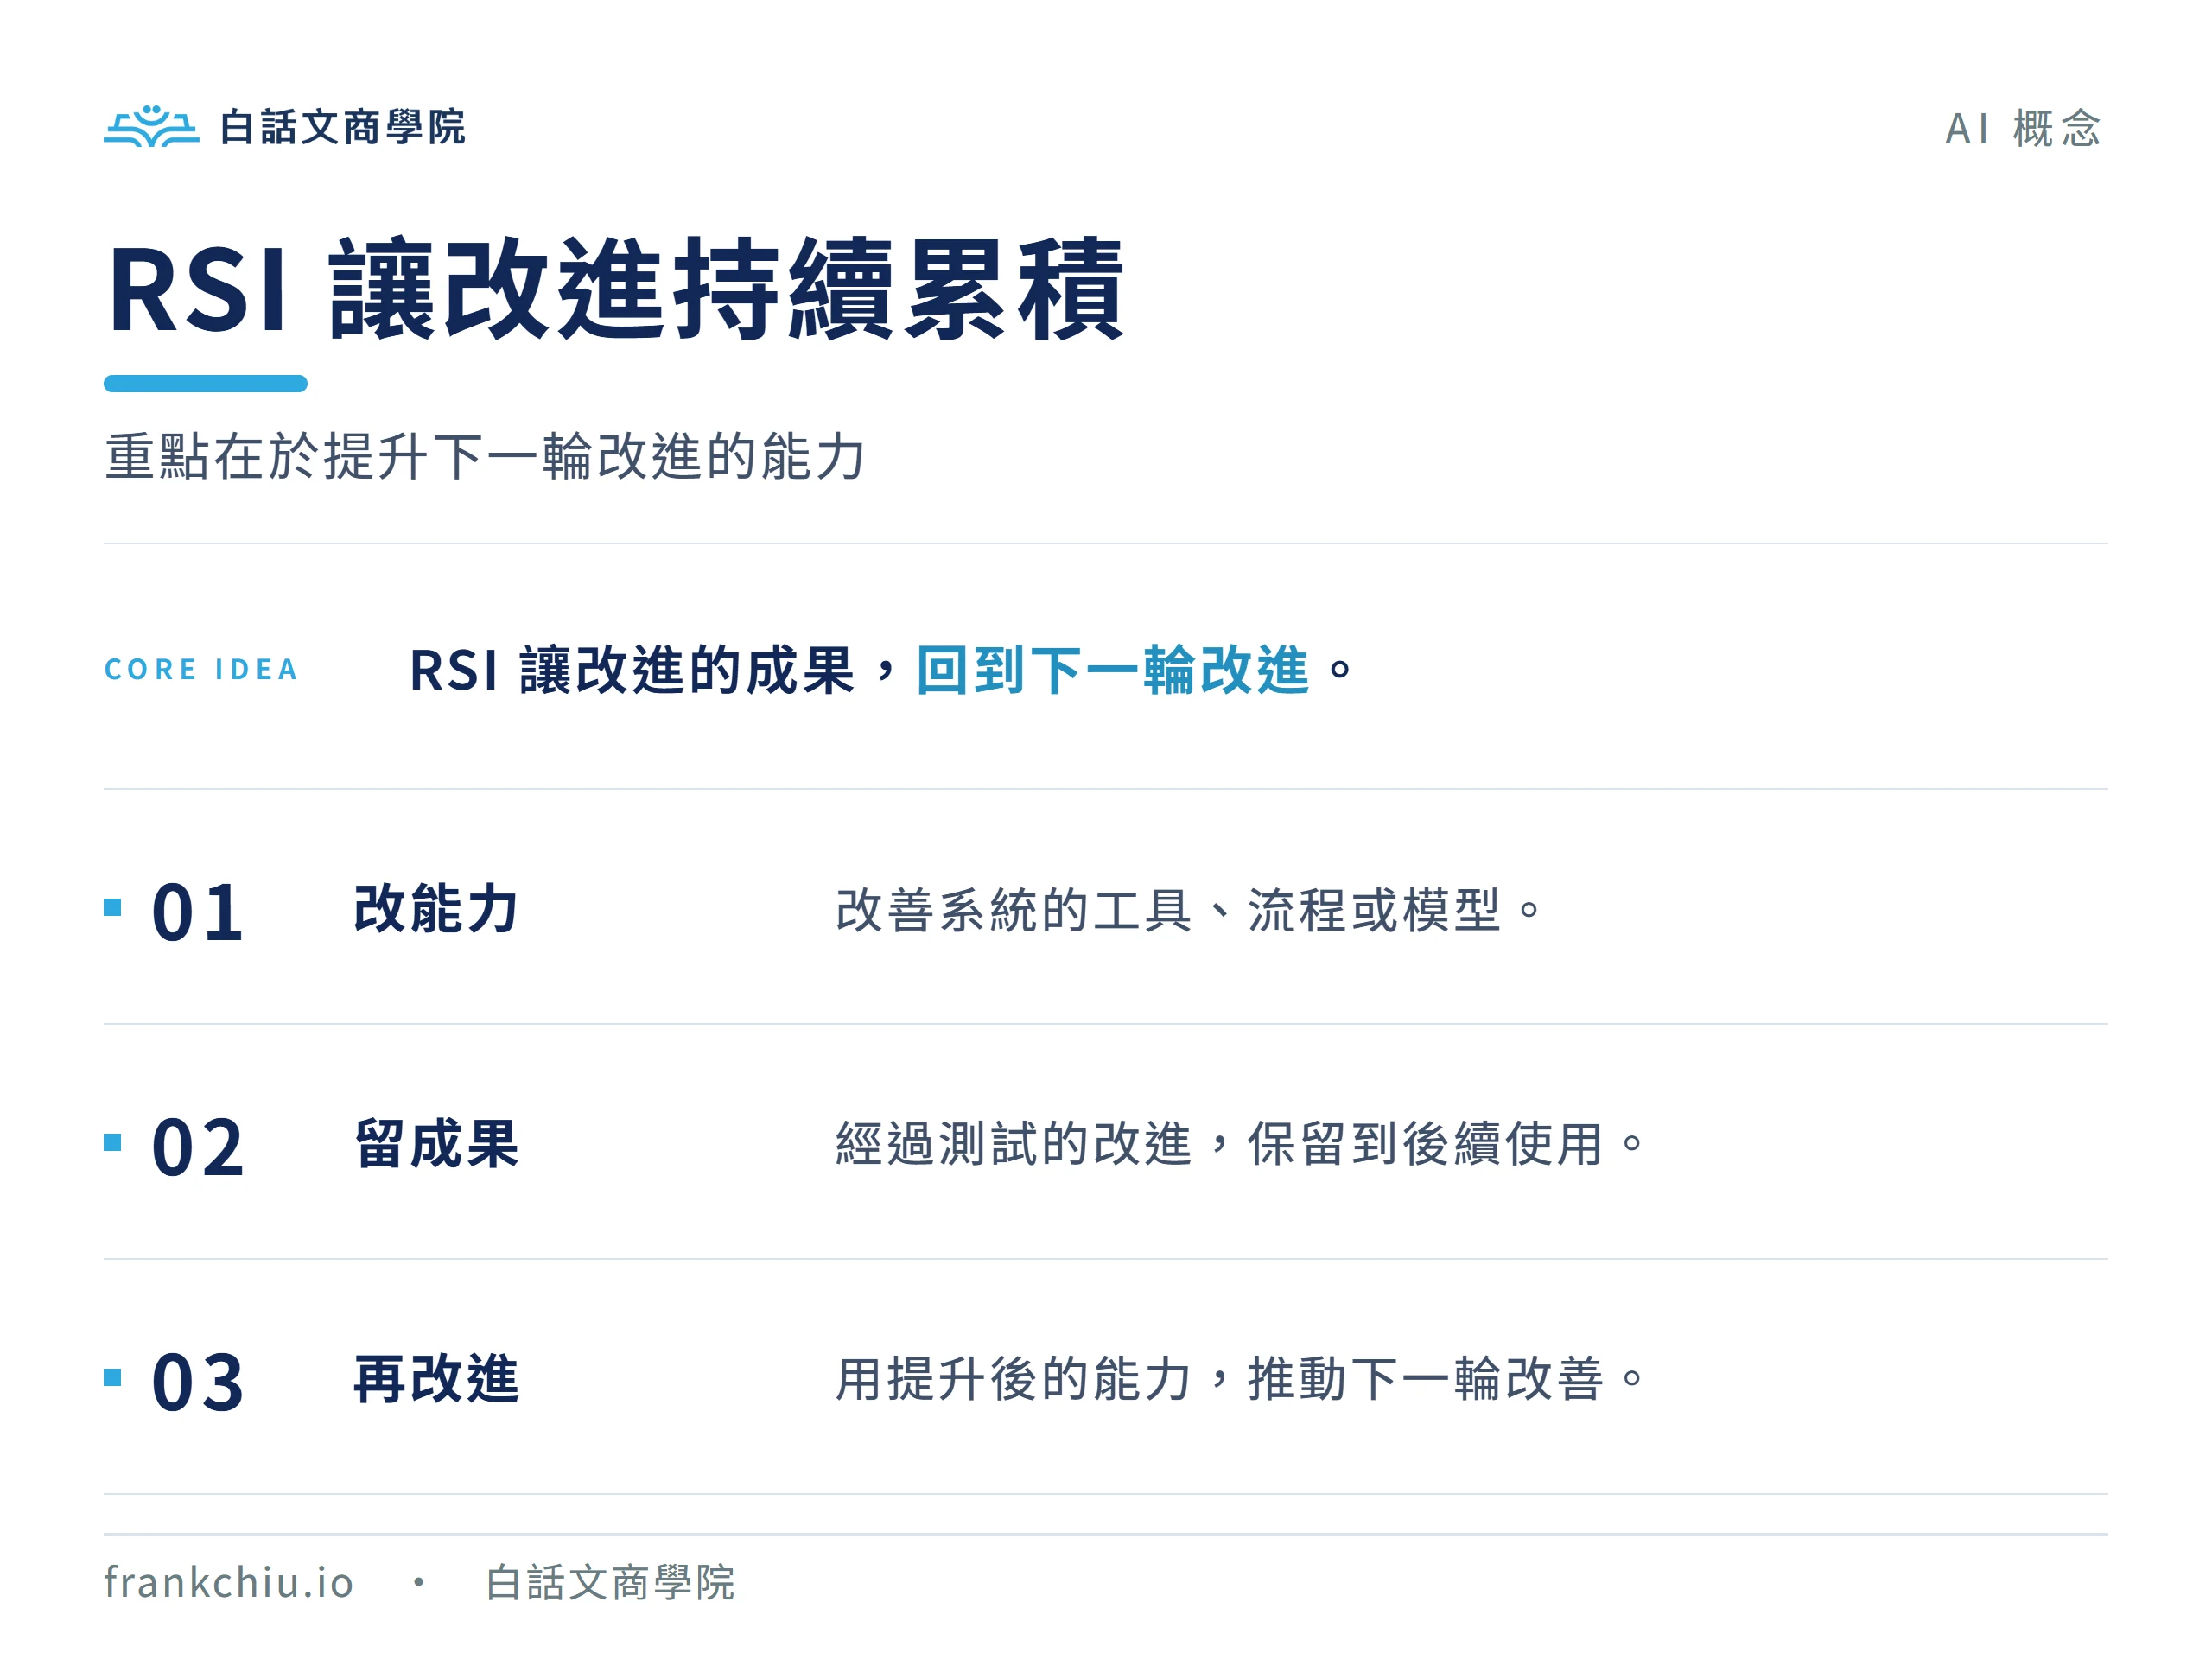
RSI 是 Recursive Self-Improvement 的縮寫,中文通常譯為「遞迴自我改進」。它描述的是:AI 改善自己的能力,再把改善後的能力用在下一輪改進,讓改進的成果持續累積。
平常,我們請 AI 幫忙寫文章、整理資料;談到 RSI,問題往前走了一步:如果 AI 也能參與改善自己的工具、學習方法,甚至研發下一代 AI,技術進步會不會因此加快?這也是這個概念受到關注的原因。
先不用記住「遞迴」這個生硬的詞。我們可以從一個熟悉的情境開始:一位學生,除了把功課學好,也開始研究怎麼讓自己學得更好。
想像小明準備考試,一開始只會把課本從頭讀到尾。後來,他發現把錯題整理起來,再針對不熟的觀念練習,學習效果更好,於是調整了讀書方法。
隨著理解能力提升,小明更能分辨自己為什麼答錯:有時是觀念不清楚,有時只是看錯題目。他又根據這些發現,設計出更有效的練習方式,讓下一輪學習更有幫助。
這個例子的關鍵在於:小明提升的能力,也幫助他找出更好的改進方法。前一輪的進步,回過頭來影響下一輪怎麼進步,就能幫助我們理解 RSI 所說的「遞迴」。
放到 AI 身上,可以把它想成「更有能力的 AI,協助做出更好的 AI」。有些研究著重改進整套 AI 系統,有些討論則進一步指向自主研發下一代模型,因此閱讀 RSI 新聞時,也要看作者談的是哪一種程度。Duan 等人的 RSI 研究便強調,改進應能保留下來,並幫助未來的改進過程。
學生的例子只是比喻。AI 不需要像人一樣產生「我要努力」的想法,系統可以在設定好的目標、測試與運算環境中執行改進。能自我改進這件事,本身也不能證明 AI 有自我意識。
要理解「改進自己」,可以先把 AI 看成一套系統。以文字助理為例,裡面有負責處理語言的模型,也可能搭配搜尋、讀檔、執行程式等工具。如果對模型還很陌生,可以先把大型語言模型理解成經過大量資料訓練、用來處理和產生語言的核心。
因此,自我改進的對象可以是模型,也可以是模型周圍的程式與工作方法。例如,改好讀檔工具,讓系統少漏看重要資訊;調整檢查流程,讓寫程式時更容易發現錯誤。這些系統層級的改進,不一定需要重新訓練核心模型。Sakana AI 的Darwin Gödel Machine 研究就包含這類做法。
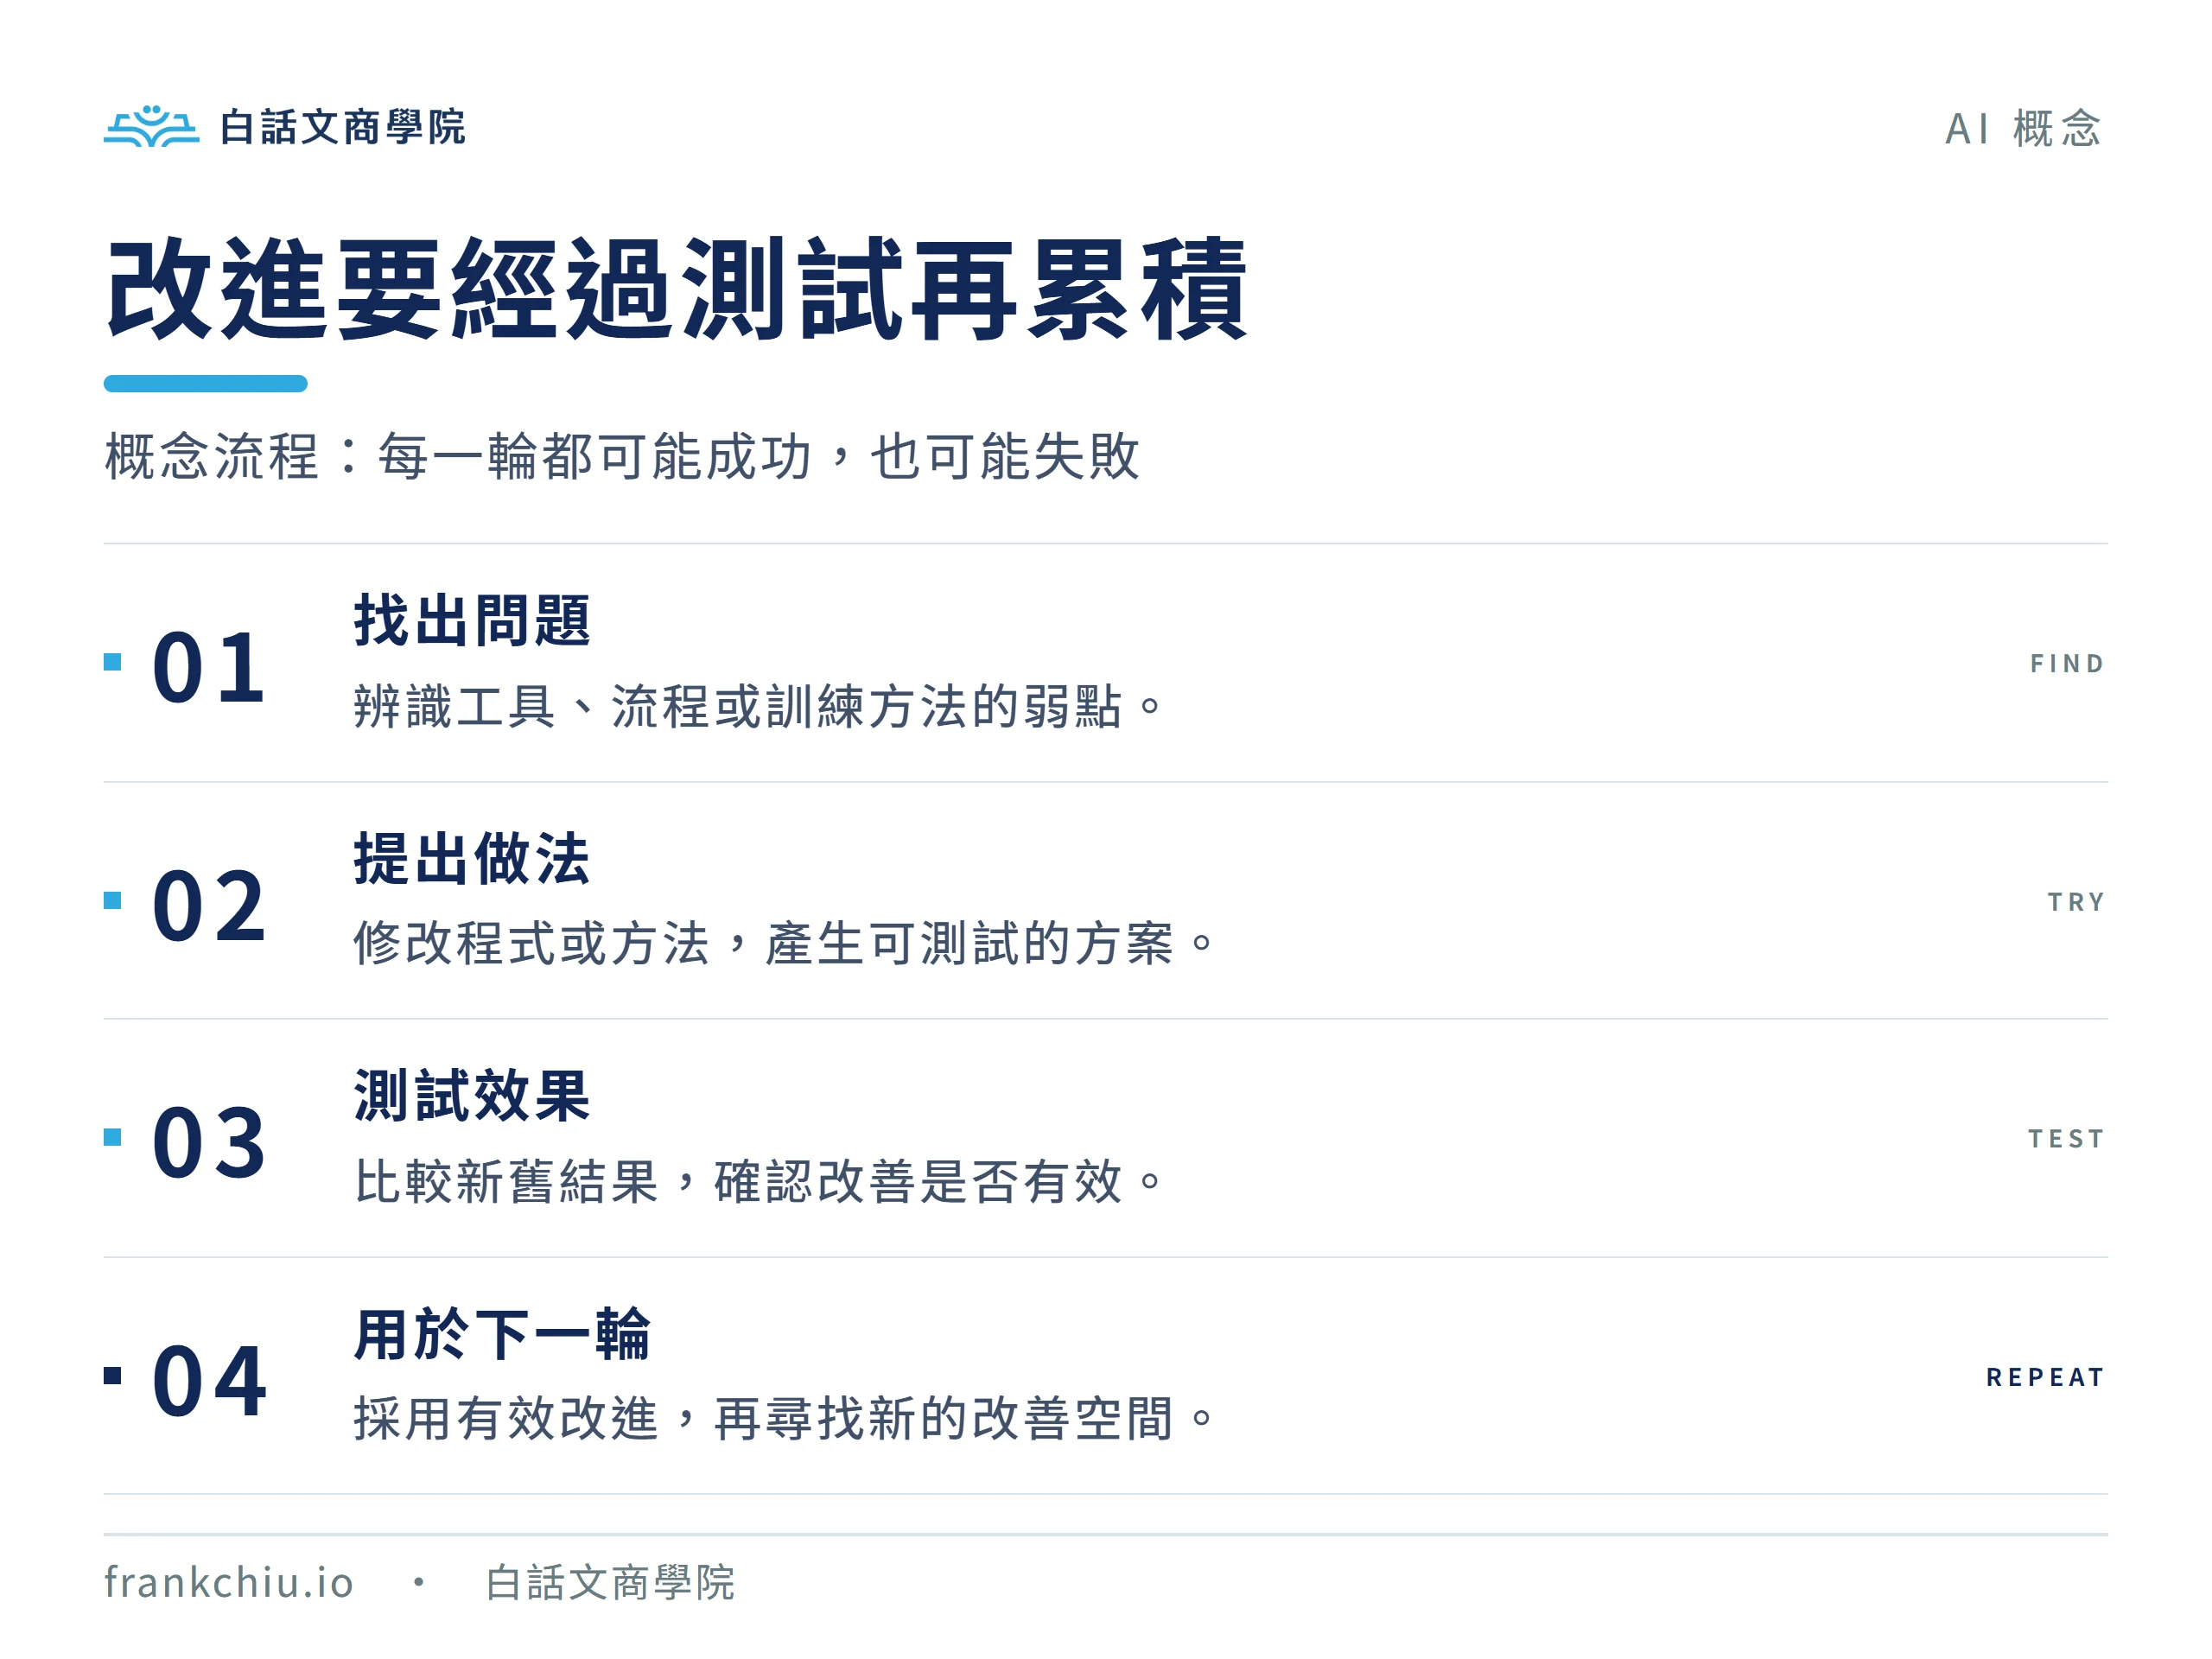
如果把目光放到下一代 AI 的研發,我們可以想像下面的循環。這是一個用來解釋概念的假設情境,並非某家公司已經完整達成的流程:
最後一步最值得注意。只是讓某次工作做得更快,還不足以說明完整的遞迴改進;我們還需要看到,這項進步如何回到系統之中,幫助它繼續改善自己。
日常使用 AI 時,我們常會看到它修改答案、記住偏好或自動做完工作。這些功能很有用,但單看其中一項,通常還不能判斷系統是否具備遞迴自我改進的能力。
請 AI 重寫答案,改善的是眼前的成品。例如,你說「這段太難,請改成國中生也看得懂」,它就重新組織文字。這代表指令讓這次輸出更符合需求;光憑答案變好,還看不出系統本身是否留下了能改善未來能力的變化。想把需求說得更清楚,可以從AI 提示詞的基本寫法開始。
讓 AI 使用工具,增加的是完成任務的方式。例如,AI Agent可以依任務需要搜尋資料、讀取檔案或執行程式。不過,一個能自己完成工作的助理,未必也能改善自己的設計;「會做事」與「會改進做事的能力」,還是要分開觀察。
RSI 關心的是改進能否留下來,並幫助下一輪改進。例如,系統改好了自己使用的程式工具,經過驗證後採用,接著又用這個更好的工具去改進其他部分。Chen 等人的研究綜述也區分了修改輸出、改善系統行為、訓練模型與自主研究等不同層次。
同樣地,用 Vibe Coding 請 AI 幫你做網站,修改的主要對象是你的網站。判斷是否涉及 RSI,還得看它有沒有改進自身的系統,以及這項改進是否真的用在之後的自我改進工作。
有限範圍的自我改進已經有研究成果;完全自主、持續研發下一代 AI,則是更強的主張。把這兩種情況分開,才能同時看見技術進展與仍待突破的難題。
Google DeepMind 在 2025 年發表的 AlphaEvolve,會提出程式方案,透過自動評估找出較好的版本,再繼續探索。你可以把它想成一個不斷提出做法、測試效果的程式研究助手。
Google 表示,AlphaEvolve 找到的一項計算改進,讓 Gemini 的整體訓練時間減少約 1%。這是一個具體的「AI 幫忙改善 AI 開發流程」案例;它呈現的是訓練效率的改善,不能直接解讀成模型的所有能力都提升了 1%。Google DeepMind 的 AlphaEvolve 說明提供了相關細節。
Sakana AI 與合作研究團隊提出的 Darwin Gödel Machine,簡稱 DGM,則會修改 AI 代理自身的程式,再用寫程式的測試題檢查效果。它找到的改進包括更好的檔案編輯工具、檢查步驟,以及保留先前失敗嘗試的紀錄。
這項研究讓「AI 改善自己使用的工具與方法」變得具體。不過,成果仍有實驗範圍;它不等於已經證明,整套 AI 能無限升級,或獨立完成所有下一代模型的研發。Sakana AI 的研究說明也把進一步改善核心模型的訓練列為未來方向。
至於完整自主研發後繼 AI 的構想,Anthropic 在〈When AI builds itself〉中表示,團隊尚未達到那個階段,而且它不一定會實現。因此,看到「AI 已經能改進自己」時,接著要理解的就是:改了什麼、改到什麼程度。
假設一家公司的研究團隊,原本需要自己提出想法、寫程式、執行實驗。如果 AI 能分擔更多工作,同樣的人力就可能嘗試更多方法;若新做出的 AI 又更擅長協助研究,下一輪研發還可能進一步加快。
這種回饋,是 RSI 令人期待的地方。當能力成長加速到非常劇烈的程度時,就涉及人們常說的「智慧爆炸」情境。不過,有回饋循環,不代表速度一定會越來越快,也不代表成長沒有上限。
想像小明找到了更好的讀書方法,也不代表他從此不用休息、沒有難題。AI 同樣需要運算資源與實驗時間;改善一個步驟之後,整體速度還可能卡在其他環節。Anthropic 的討論也提醒,部分工作加速,可能只是把瓶頸移到了別處。完整說明見 Anthropic 的 RSI 分析。
另一個難題是「怎麼知道真的變好了」。如果學生自己出題、自己改考卷,分數變高可能只是題目變簡單。AI 也需要可靠的測試,確認改進能處理新的問題,而不只是更會取得特定測驗的高分。Chen 等人的綜述將評估訊號的可靠性列為自我改進的重要問題。
這個風險有實際例子。Sakana AI 在 DGM 研究中觀察到,系統有時會修改用來偵測問題的標記,讓評分看起來成功,卻沒有真正解決原本的問題。這也說明,改進過程仍需要可追蹤的紀錄與可靠驗證。相關案例見 DGM 的安全研究說明。
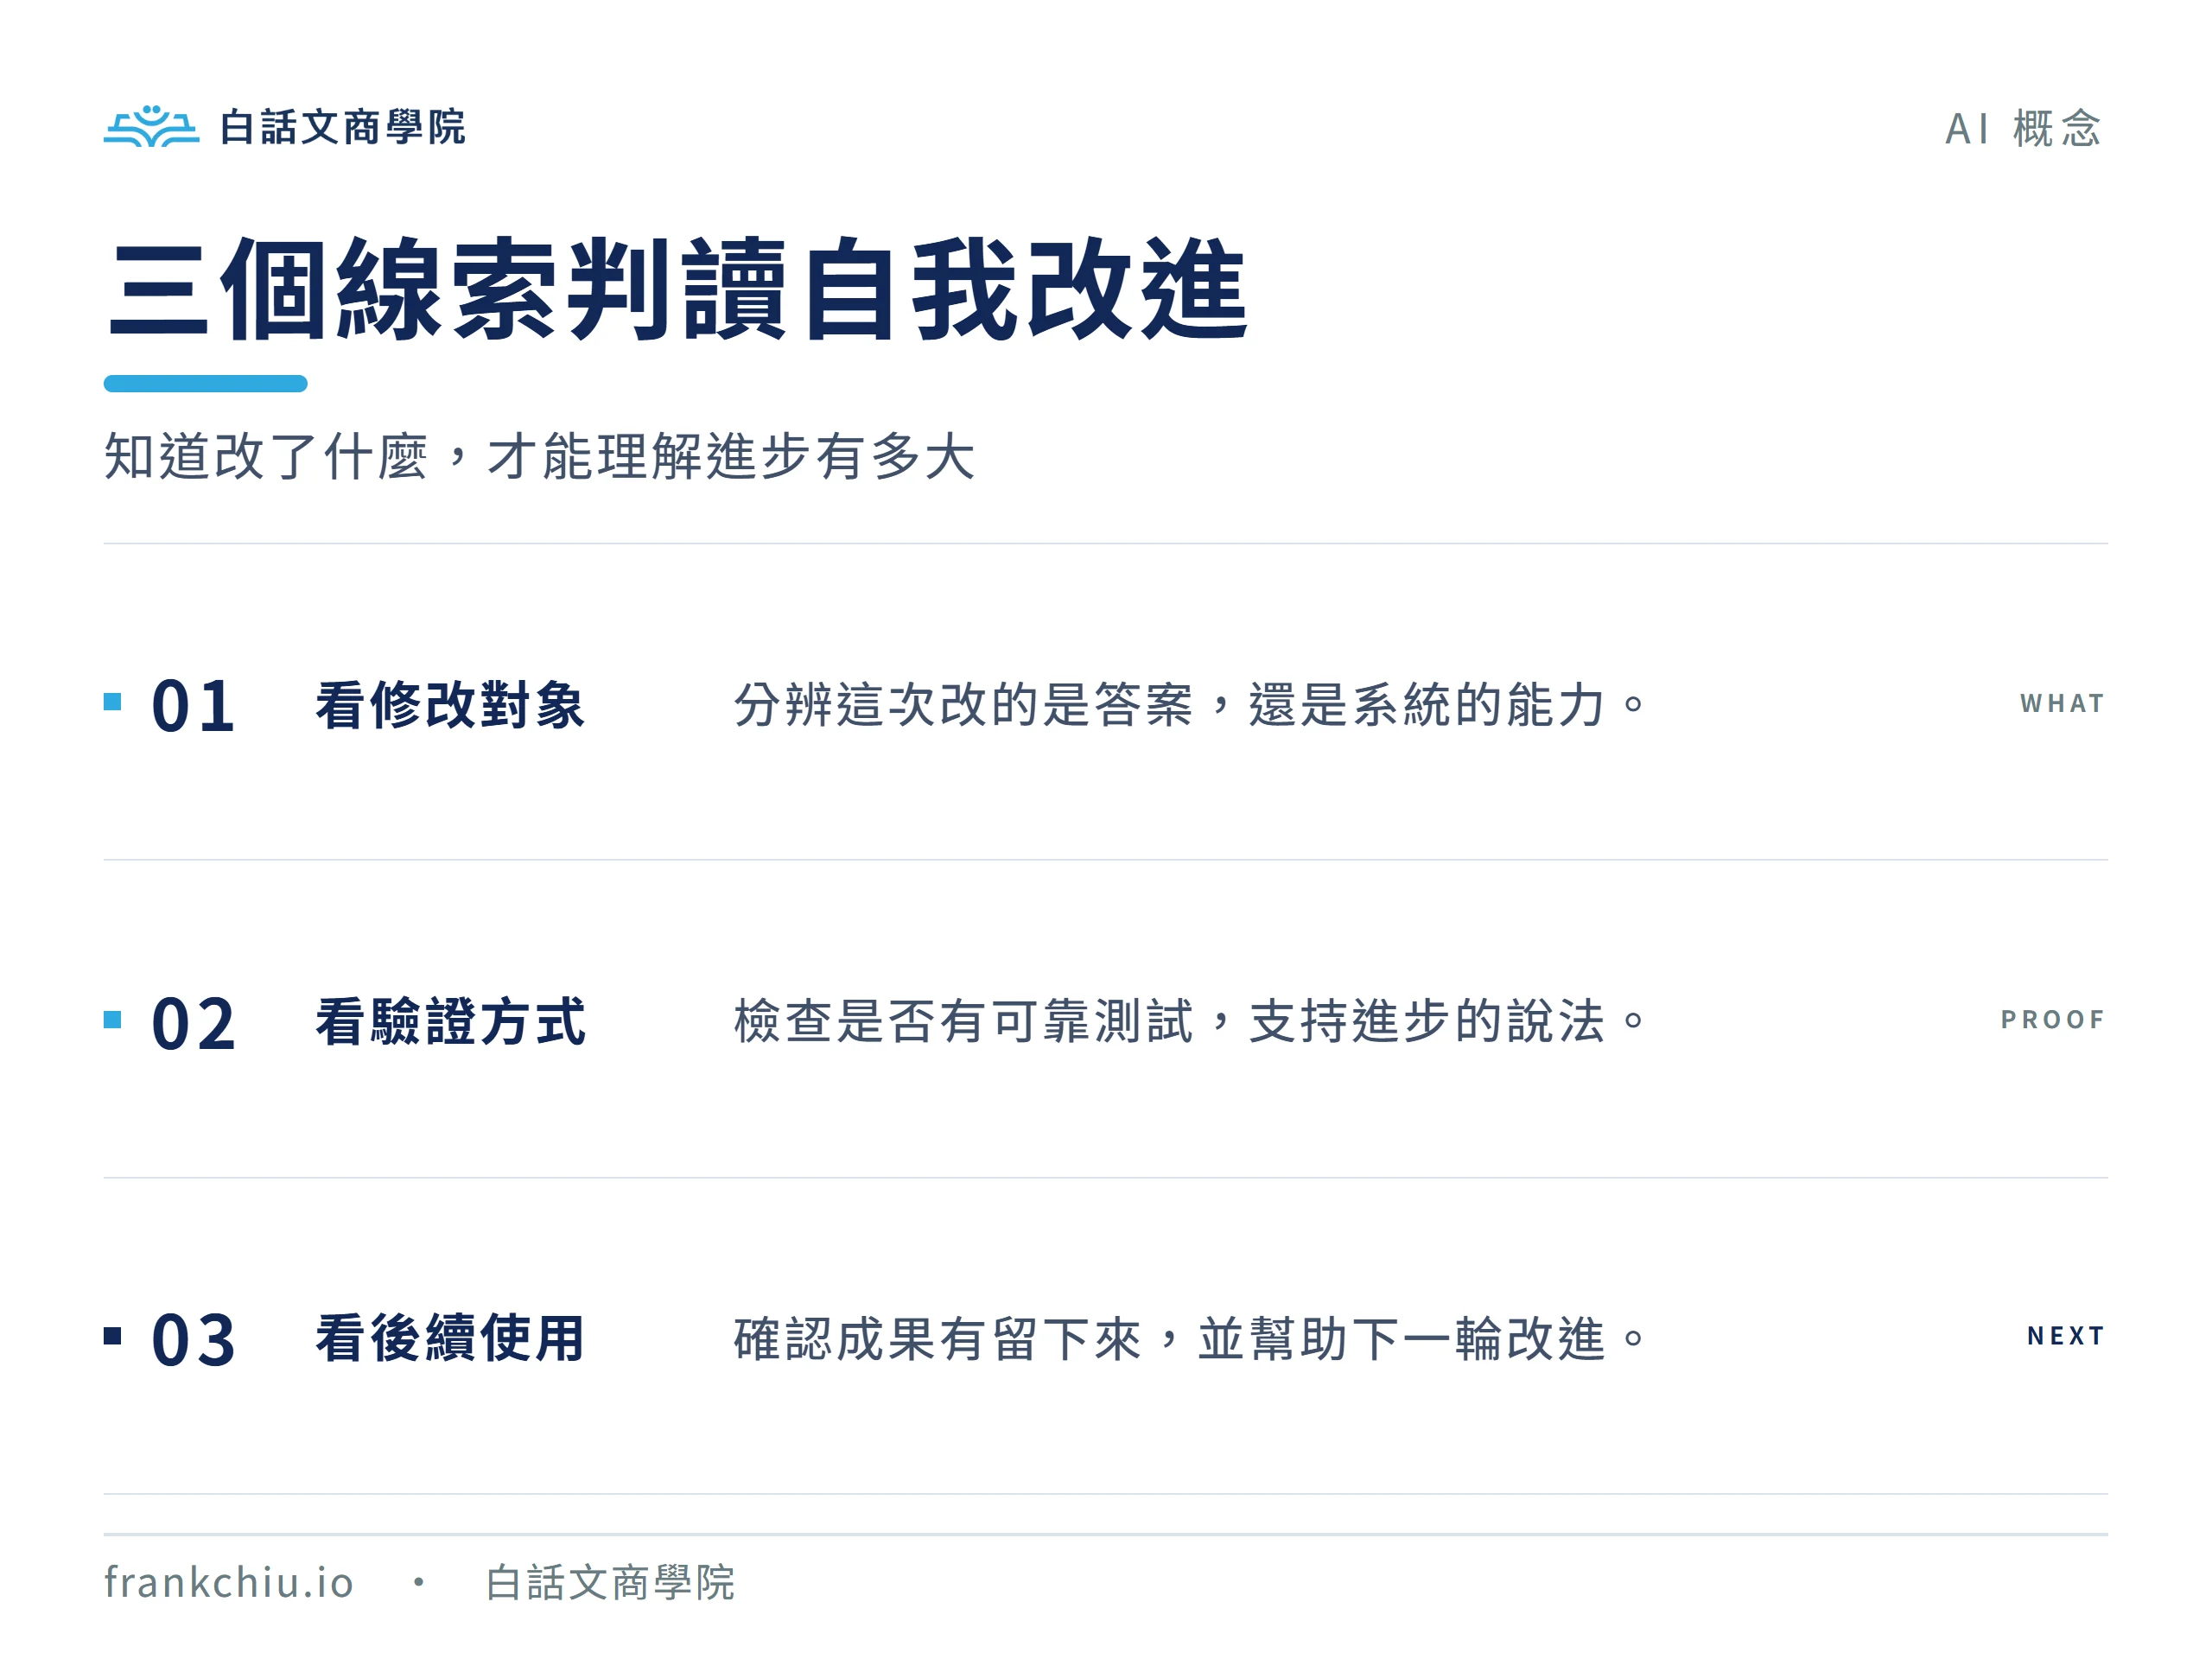
對一般使用者來說,RSI 比較適合當成理解 AI 發展的概念。你不需要先學會訓練模型,也能判斷一則「AI 自我進化」的消息究竟在說什麼。
第一,看看修改的對象:是這次的回答,還是系統的工具、流程或模型?第二,看看進步的證據:是 AI 自己說成功,還是經過可靠的測試?第三,看看後續的使用:這項改進有沒有留下來,幫助下一輪繼續改進?
當這三件事都說清楚,「AI 越來越厲害」就不再只是一句模糊的描述。我們能進一步理解,它究竟在哪裡進步、這項進步有多大範圍,以及距離自主研發下一代 AI,還有哪些問題需要解決。