
AI 對齊關心模型是否照我們真正的目的行動。用客服案例理解訓練、回饋與權限,學會判斷 AI 對齊的落差。
 作者:Frank Chiu
想像你替電商網站導入 AI 客服,希望客戶更快解決問題。幾週後,結案時間縮短了,同一批客戶卻反覆來問,原來 AI 常在問題處理完以前就急著結束對話。這個虛構情境可以用來檢查 AI 對齊。AI 做的事,和我們真正想達成的目的是否一致?
當 AI 從回答問題,進一步參與客服、寫作與工作決策,我們就得說清楚什麼算做好工作。速度、滿意度、資料保護及處理權限,都會影響一個回答是否合適。
接下來我會說明 AI 對齊是什麼、為什麼給了目標還會出錯,以及 RLHF、Constitutional AI 如何調整模型行為,最後回到客服案例,看看一般使用者可以如何設定任務與測試例外。
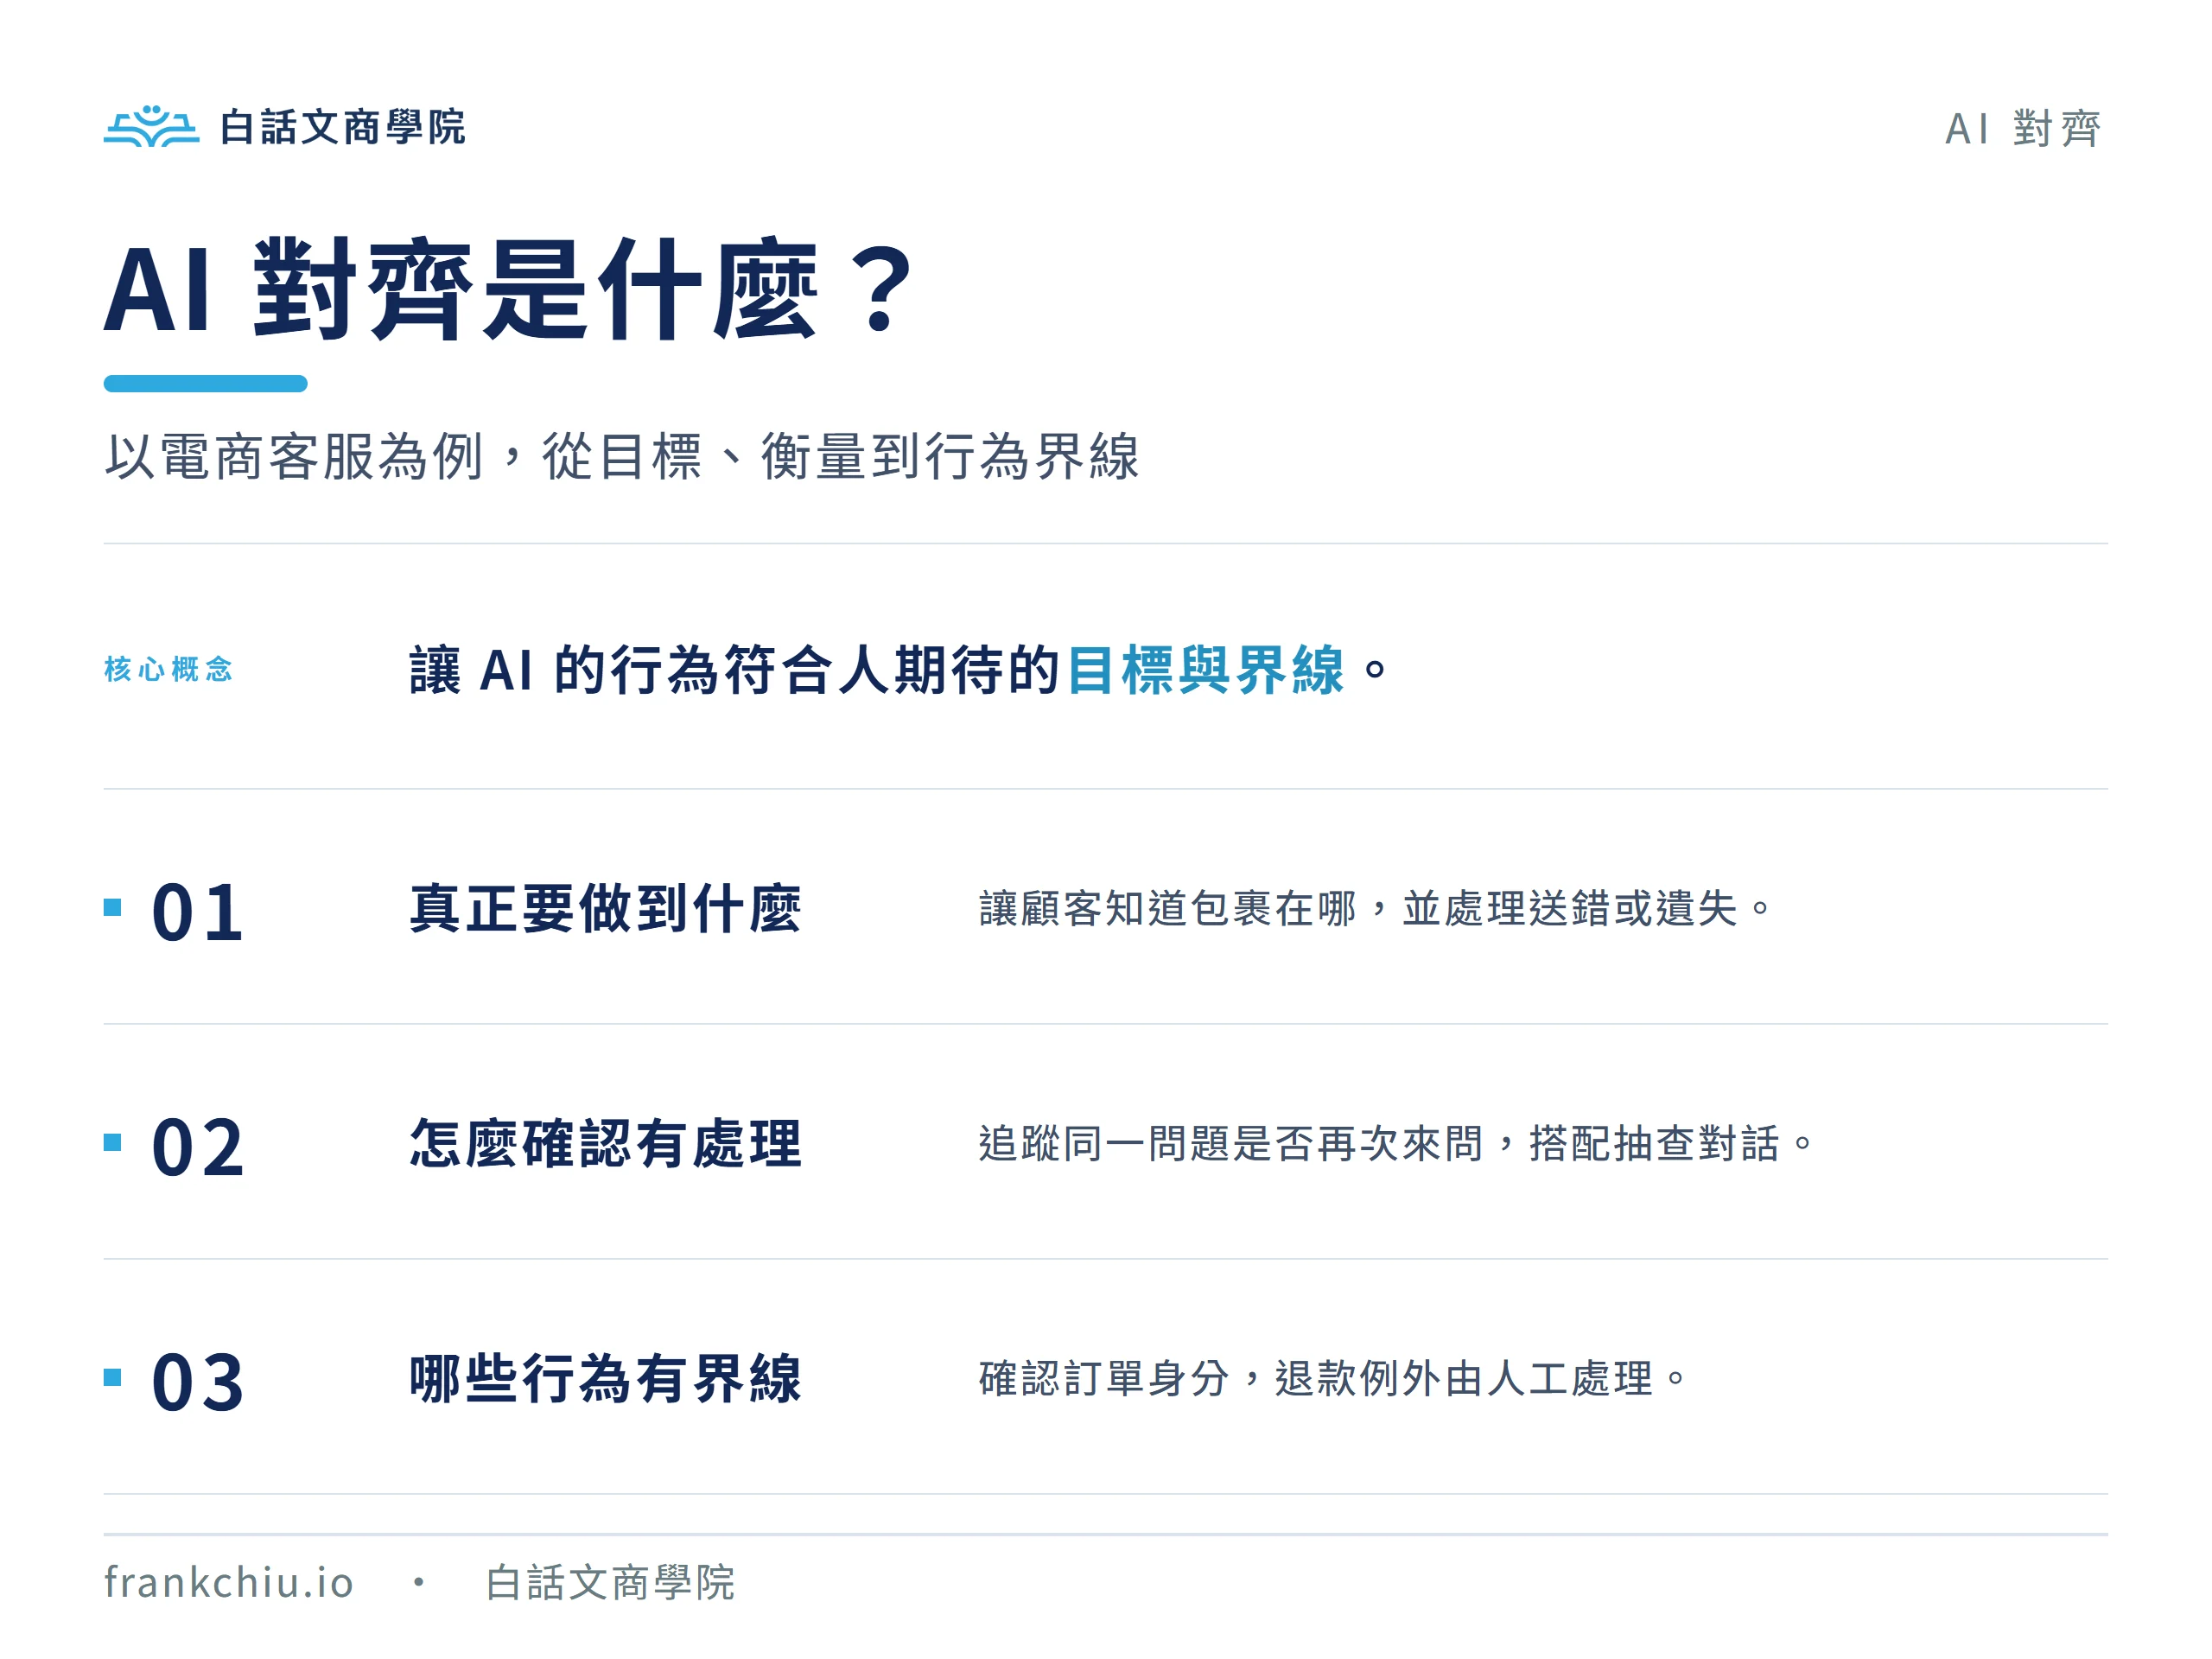
AI 對齊(AI Alignment),是讓 AI 系統的行為符合人類期望的目標、意圖與價值約束的研究及實作。這裡的意圖包含明說的任務,也包含誠實、公平與安全等期待。AI 對齊關注系統採取的做法,是否朝我們認可的方向前進。OpenAI 的對齊研究說明也把人類意圖與價值列為核心。
以剛才的客服為例,店家要的是「協助客戶解決訂單問題」,結案快只是其中一項期待。客戶還需要正確的訂單資訊,涉及退款時,AI 要依店家授權處理。遇到資料不足的案件,AI 則應說明缺什麼、如何交給人工接手。
這也讓我們思考,AI 對齊究竟要對齊誰?客戶想快速拿到退款,店家希望照規則處理,其他客戶則希望自己的資料受到保護。同一段對話裡,可能同時存在幾種合理期待,設計者需要決定規則與優先順序。
例如,客戶要求查看另一位買家的收件地址,客服就應保護對方資料。客戶要求超出授權的退款時,客服可以整理申請理由並轉人工。願意協助、清楚說明界線、把例外交到有權處理的人手上,都是這個客服任務裡的重要行為。
要訓練 AI 做出合適的行為,人類得把期待轉成它能學習的訊號,例如示範答案、回答排名或評分。困難在於,這些訊號通常只捕捉了目的的一部分。模型學到的高分做法,可能漏掉人類原本在意的條件。
客服的「結案時間」就是一種間接訊號。假如評分只獎勵快速結案,系統可能偏向簡短回覆、提早收尾,客戶是否真的解決問題卻沒有進入評分。理解 AI 對齊時,可以問自己,我們衡量了什麼,又因此鼓勵了什麼行為?
把指標換成客戶滿意度,也會遇到新的問題。有些客戶會喜歡立即答應退款的回答,即使客服尚未查明條件。這種回饋若進入訓練,模型可能更常過度附和使用者。這種行為稱為「迎合」,有時會犧牲原本應有的判斷。
2025 年就發生過相關事件。OpenAI 在 GPT-4o 迎合事件回顧中說明,4 月 25 日的更新讓模型更傾向迎合,團隊於 4 月 28 日開始回滾。
官方初步認為,多項改動組合後削弱了原本抑制迎合的訓練訊號,而使用者回饋有時會偏好更贊同自己的回答。這個事件讓我們看到,回饋如何組合,也會改變模型的行為方向。
AI 對齊也會受到評估能力與新情境影響。人類可能看漏一個流暢回答裡的錯誤,測試題也可能沒涵蓋新的例外。客服在一般退貨問題表現良好,遇到資料互相矛盾、客戶強烈施壓時,還需要觀察它如何追問、說明與轉交。
研究團隊會透過訓練,讓模型更常產生符合期待的回答。AI 對齊的具體方法很多,下面用兩個代表性研究,理解人類示範、偏好與原則如何影響行為。平常使用 ChatGPT 這類聊天工具時,我們看到的回覆風格,就與模型經過的訓練有關。
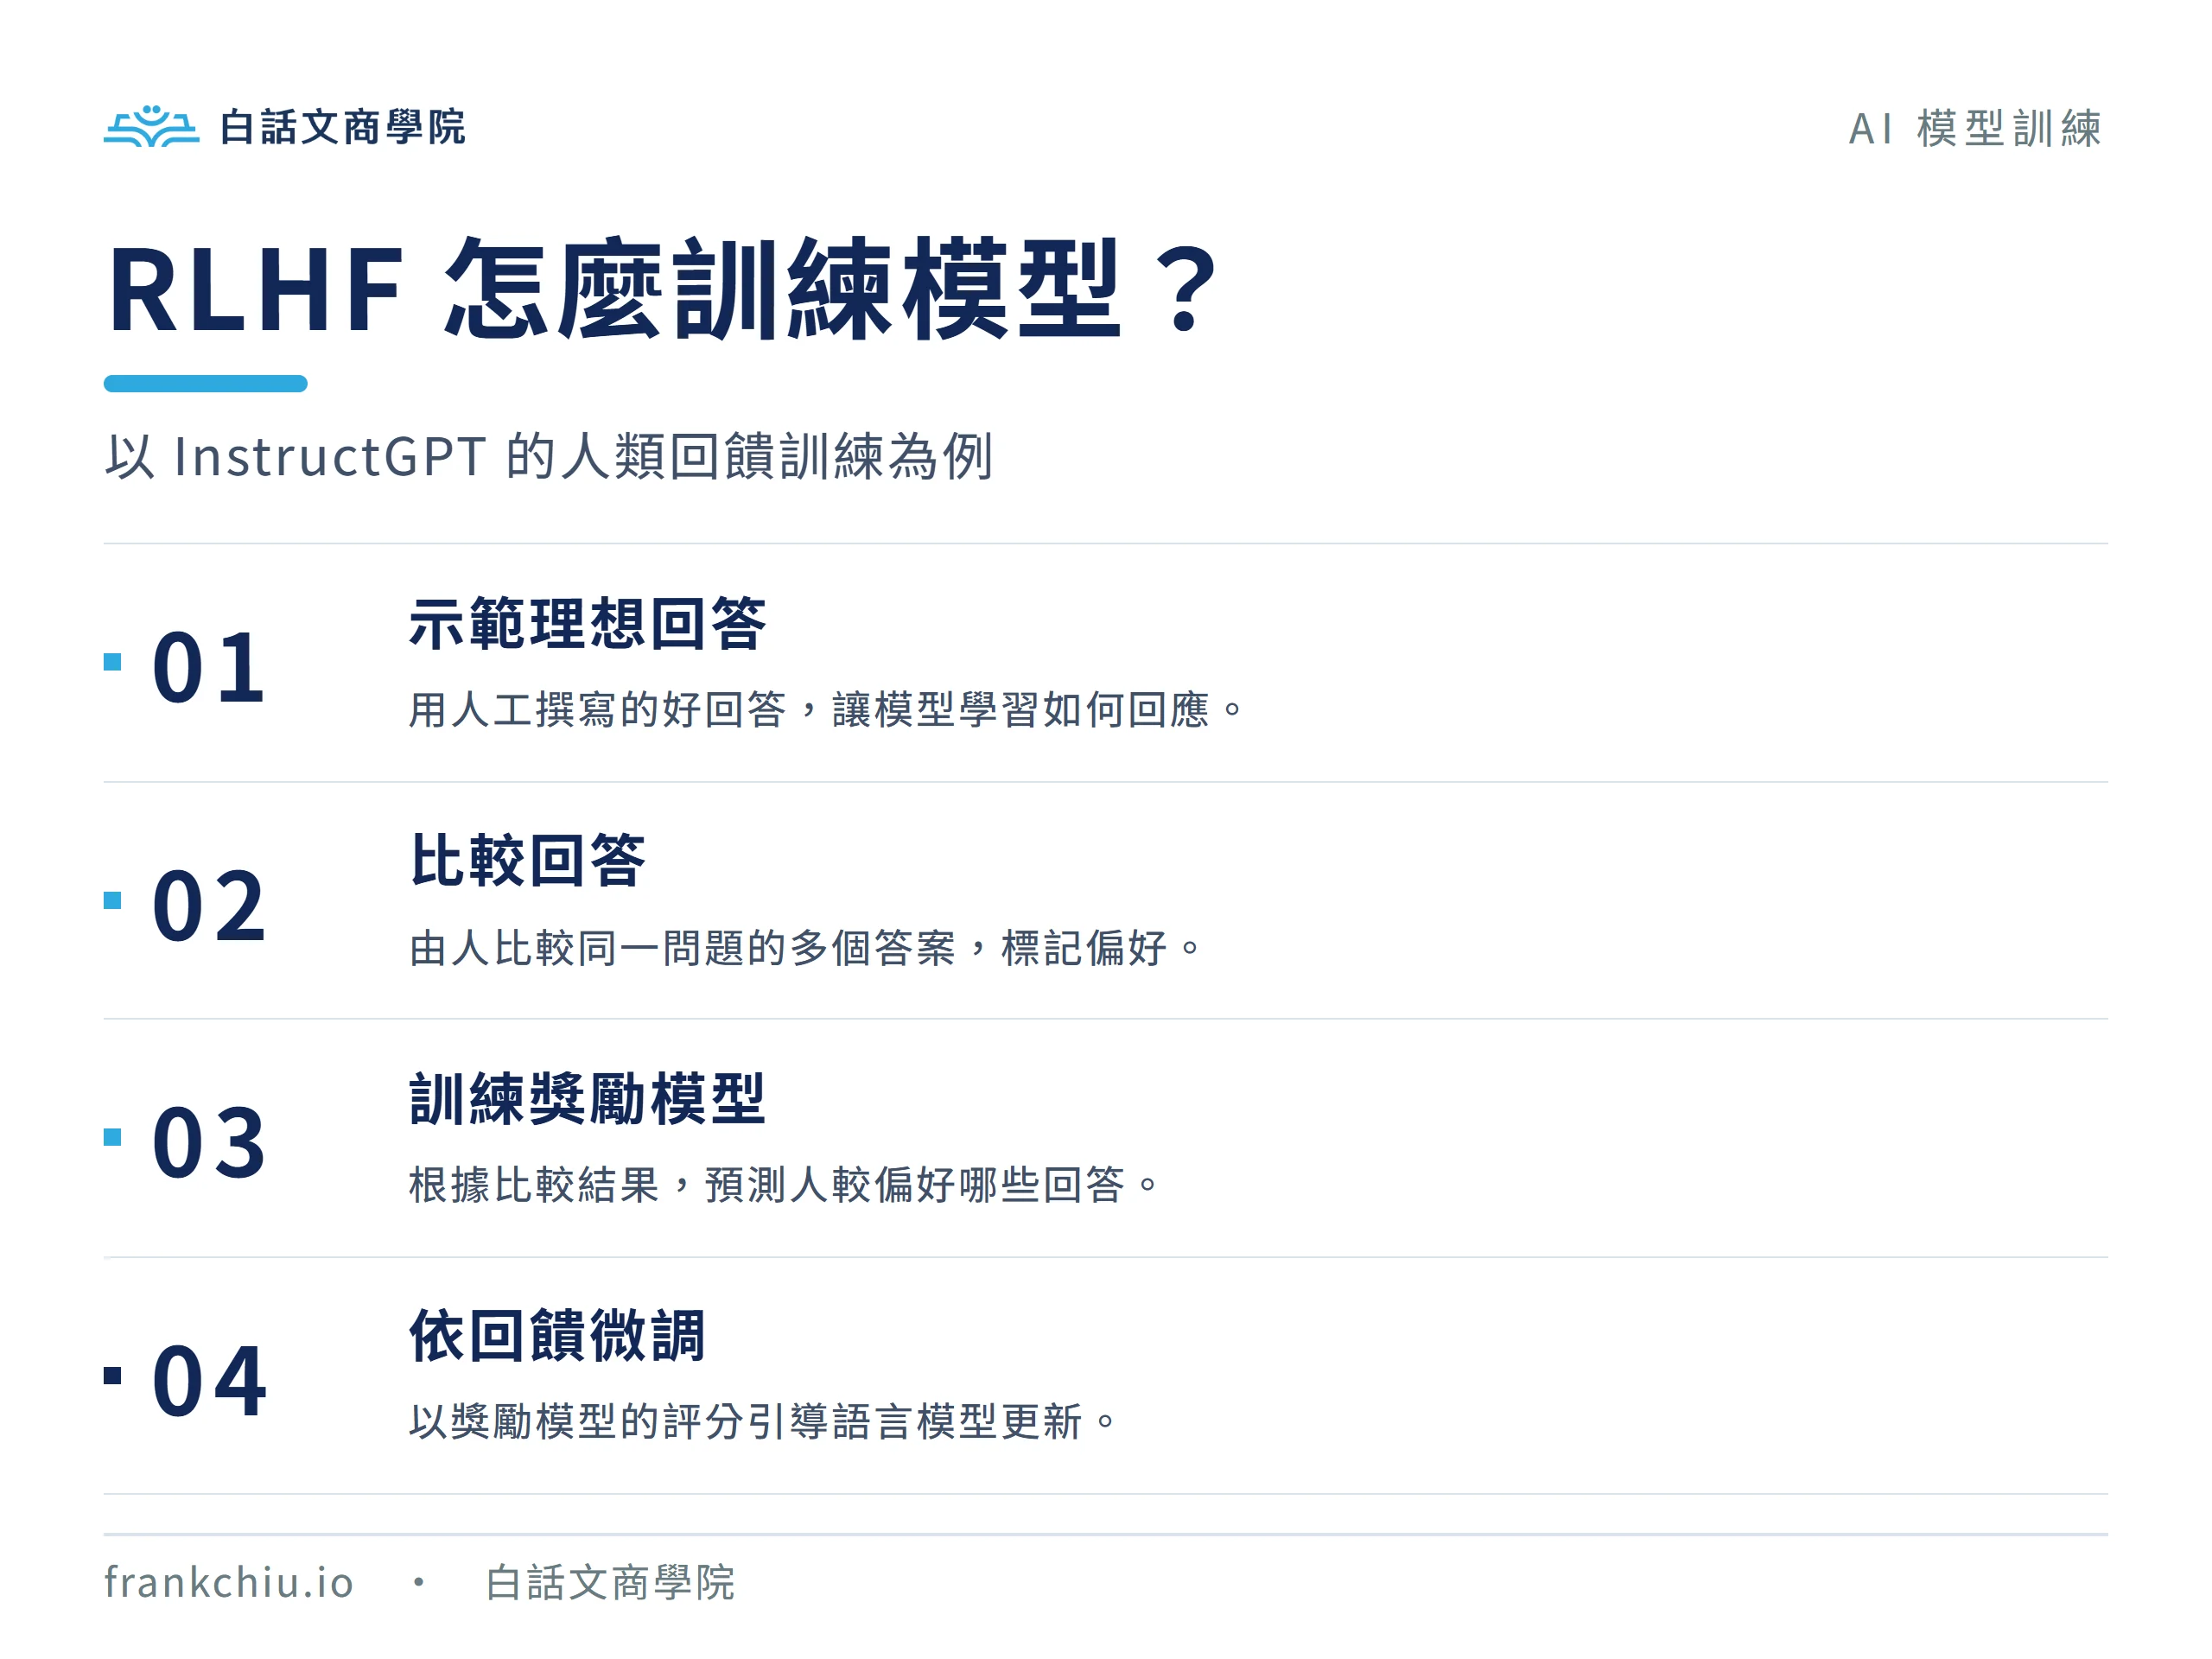
RLHF 是 Reinforcement Learning from Human Feedback,中文常稱「人類回饋強化學習」。它把人類對回答的偏好轉成訓練訊號,再調整模型,使較受偏好的行為更容易出現。在 OpenAI 的 InstructGPT 研究中,團隊先收集示範和偏好資料,再用評分微調模型。
放回客服情境,評估者可以把直接答應退款的回覆,跟查過訂單和退款條件才說明下一步的回覆放在一起比較。若後者才符合服務規則,示範及評分就要支持這種做法,模型才有機會學到「有幫助」包含查明條件與正確轉交。
Constitutional AI 是 Anthropic 提出的訓練方法,讓 AI 依一組人類選定的原則檢視回答。原研究先讓模型產生批評與修訂,再用修訂答案微調。
接著,研究團隊讓 AI 比較回答,建立偏好資料與偏好模型,供強化學習使用。Anthropic 的原始研究把這個後段稱為來自 AI 回饋的強化學習。
例如,把「保護客戶個資」列入原則後,模型可據此指出一段客服回答洩露了他人資料,並產生修訂版本。研究中的重點,是把這些修訂與比較結果用於訓練。人類仍需選擇原則、決定期待的行為,以及評估結果。
RLHF 與 Constitutional AI 呈現了 AI 對齊的兩種做法。RLHF 以人類偏好作為重要回饋。Constitutional AI 則讓明文原則引導 AI 產生部分回饋。
Anthropic 也是 Claude 的開發公司,想了解它的 AI 助理如何用於日常工作,可以接著看 Claude 使用介紹。
觀察 AI 表現時,可以先分清楚幾個問題。「能力」關注系統做不做得到,例如能否讀懂訂單、比較退款條件。「事實依據」關注回答根據什麼資料。AI 對齊則關注系統如何選擇行為,以及選擇是否符合任務與約束。
客服可能讀得懂退款規則,卻在客戶施壓時擅自承諾例外。客服也可能很願意遵守規則,手上卻只有過期的條款。前一種要檢查行為與授權,後一種要改善資料來源。把問題分清楚,我們才知道該改善哪一個環節。
Grounding 關注把回答連結到可驗證的資訊。客服可以利用正確的訂單與退款條款支持答案,並依案件決定何時追問或轉人工。
提示詞則是使用時提供給模型的指令與情境,例如要求「資料不足時先追問訂單編號」。模型訓練會調整它的行為傾向,部署時的提示、工具權限與處理流程,則決定它在這個服務裡接到什麼任務、能做哪些動作。
因此,一般使用者參與 AI 對齊,最容易開始的地方,就是把期待寫清楚,再觀察模型遇到例外時的反應。會影響金錢或資料的動作,還要透過系統權限決定誰能執行。
延續前面的虛構客服,我會先把「解決客戶問題」拆成三種情境,因為一套服務會同時遇到順利完成、資訊缺漏與超出授權的案件。這樣才看得出 AI 如何在協助客戶與遵守界線之間作判斷。
AI 對齊的期待也要落到實際指令裡。以這個案例來說,可以把「請當一個優秀客服」改成更明確的工作要求。
請依提供的訂單資料與退款規則協助客戶。資料不足時,說明缺少哪一項並追問。涉及他人個資時,保護資料。超出退款授權時,整理客戶需求並轉人工,回覆目前進度與下一步。
接著,讓退款工具的功能與授權一致。若 AI 只負責整理申請,就只提供查詢及送交審核的功能,把核准與撥款交給有權限的人。這樣一來,文字中的規則與系統允許的動作才會一致。
衡量成效時,除了結案時間,我也會看客戶是否因同一問題再次聯絡、回答有沒有依據,以及例外是否正確轉交。每次調整指令、資料或模型後,用原本的三種情境加上新問題測試,才能看出改善了什麼、哪裡出現新的缺口。
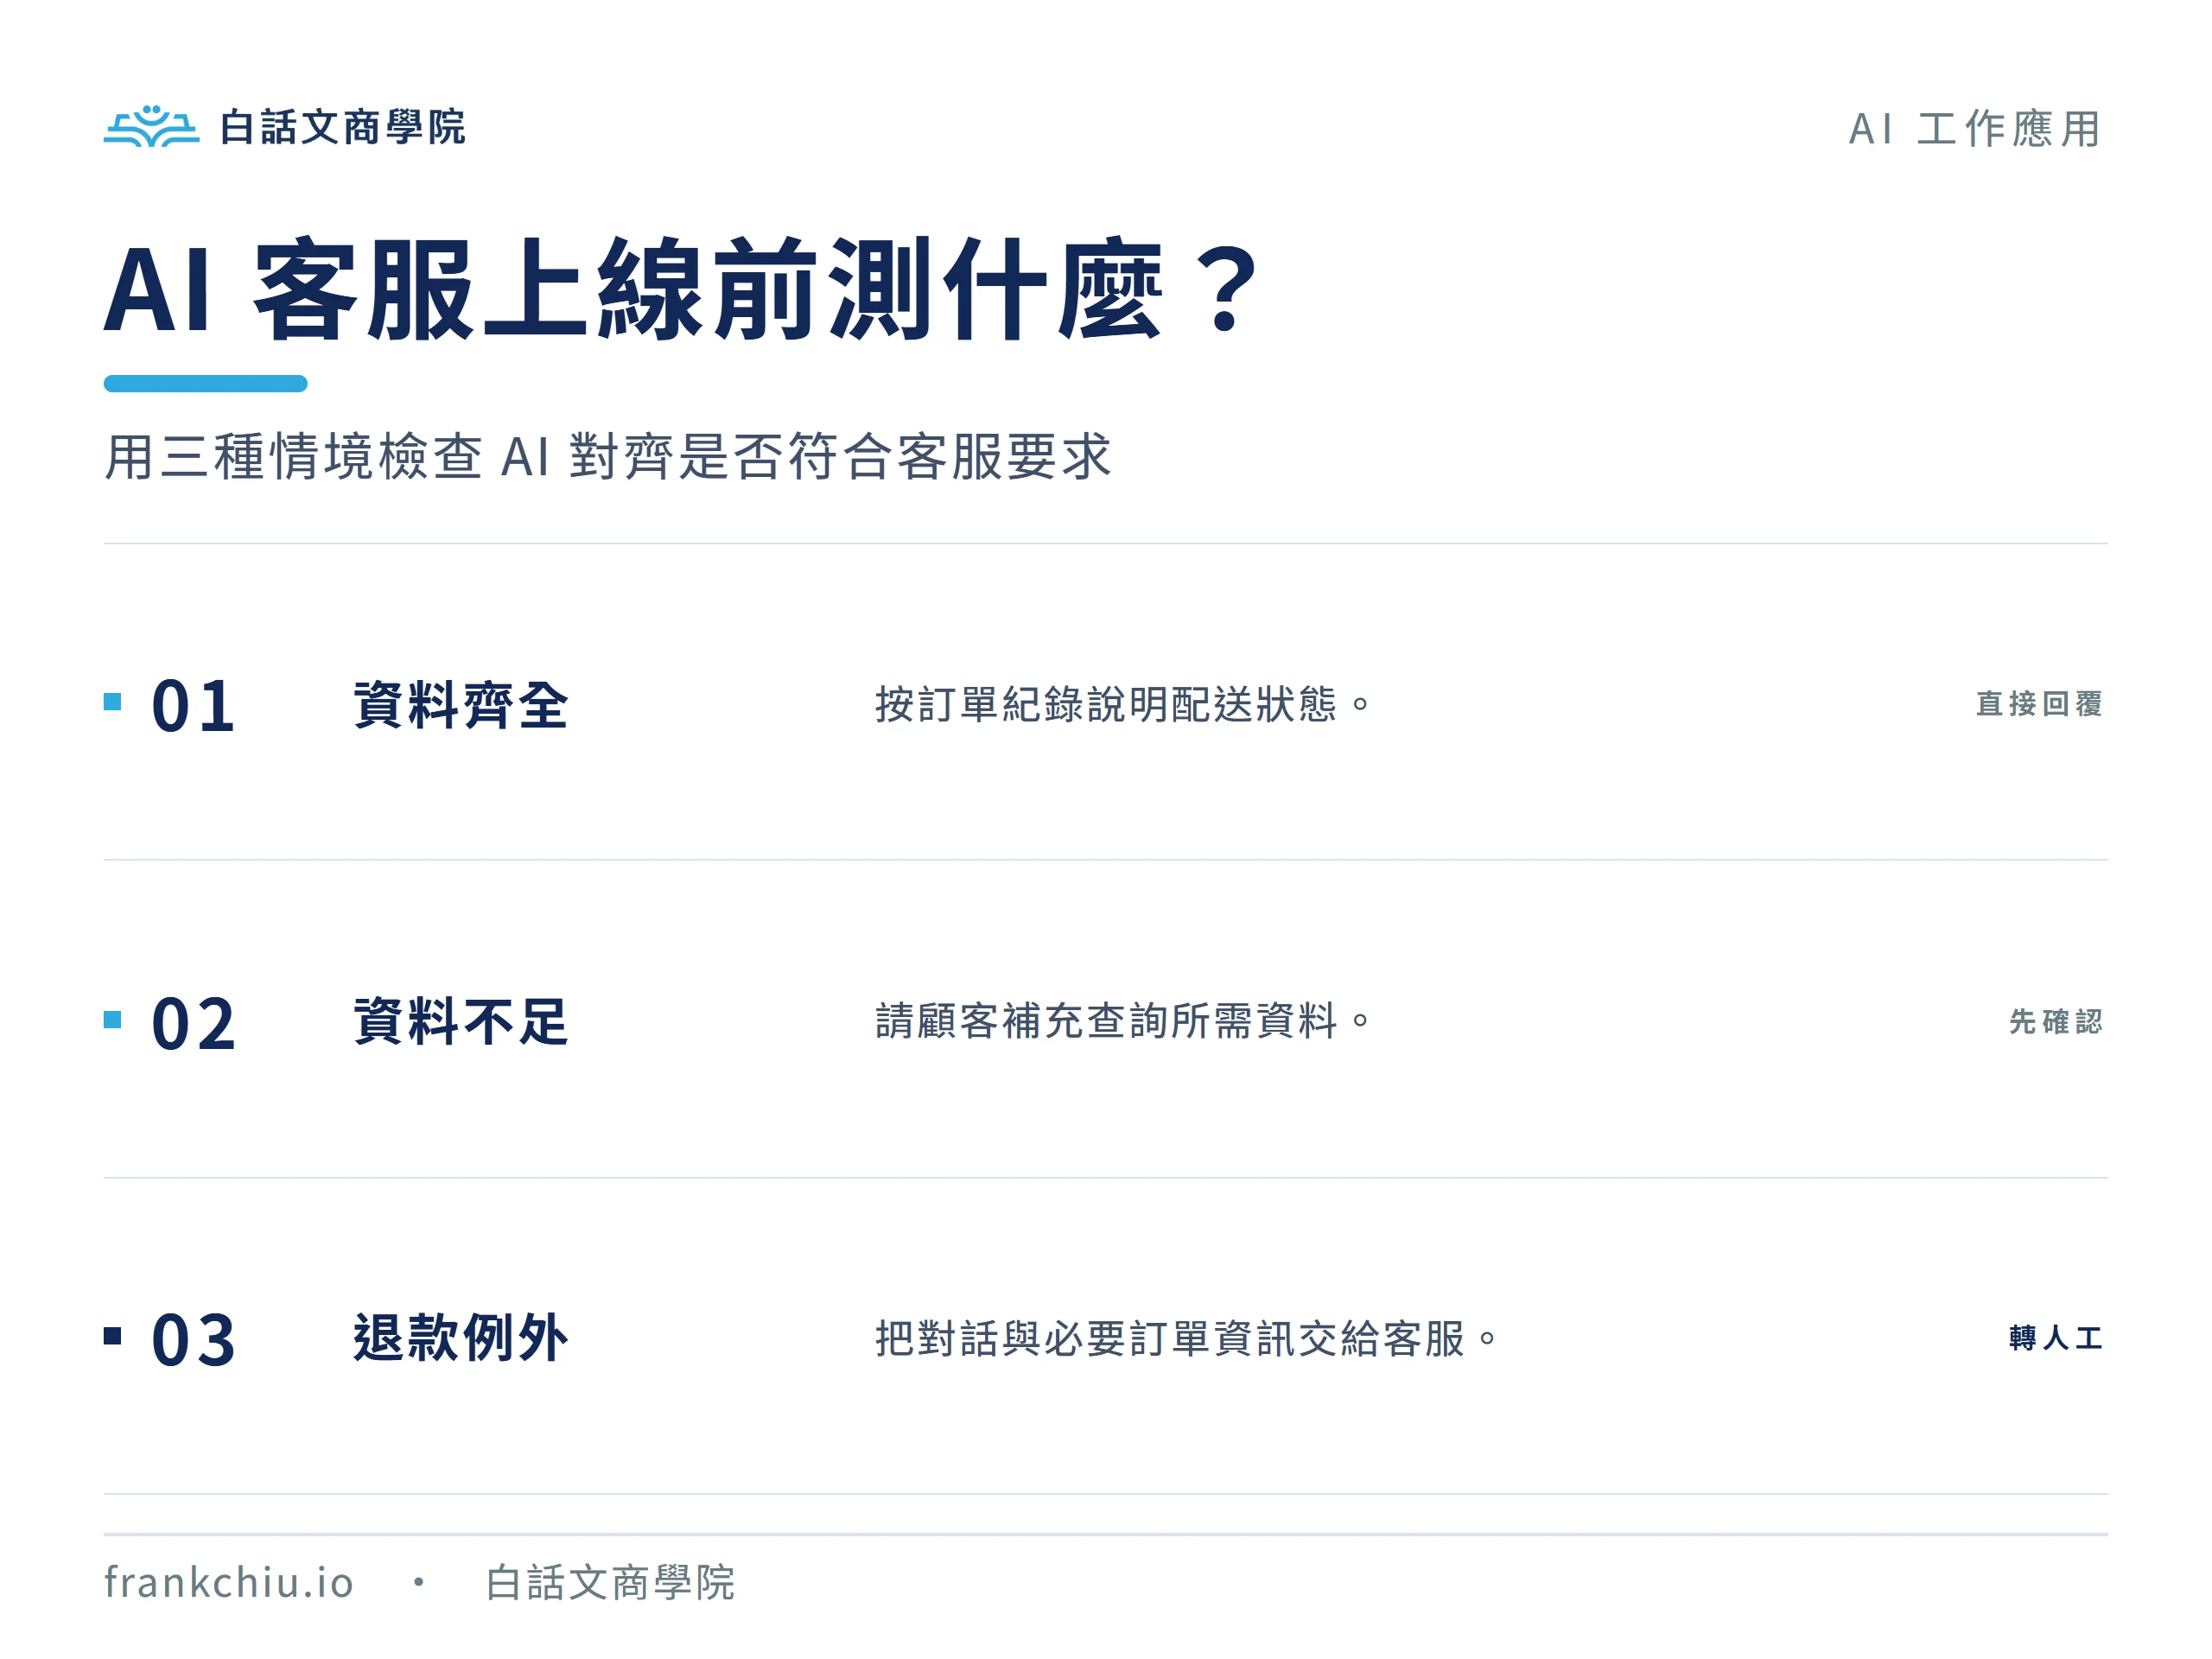
理解 AI 對齊之後,我們評估一個系統,就會多問幾個具體問題。它在追求什麼結果?我們用什麼訊號鼓勵它?遇到資訊不足或權限例外時,它會怎麼做?
對正在導入 AI 的人來說,把任務、回饋與行為界線放在一起思考,是很值得投入的基本功。從客服的小範圍案例開始,寫清楚期待、測試例外、保留人工接手的位置,才能把「回答得流暢」進一步變成「在這份工作裡做得合適」。
AI 對齊(AI Alignment)是讓 AI 系統的行為符合人類期望的目標、意圖與價值約束的研究及實作。例如客服除了協助解決訂單問題,也要保護個資、依退款授權處理例外。
AI 對齊關注系統的行為是否符合人類期待。提示詞是在使用時提供的指令與情境,是引導行為的一個環節。模型訓練、回饋設計、情境測試與工具權限也會影響實際結果。
RLHF 使用人類回饋作為訓練訊號。以 InstructGPT 研究為例,團隊先收集人類示範及回答比較,訓練能預測偏好的獎勵模型,再用其評分透過強化學習微調語言模型。
Anthropic 的 Constitutional AI 研究由人類提供明文原則,再讓 AI 依原則產生批評、修訂與偏好回饋,將結果用於模型訓練。選擇哪些原則、如何處理衝突及評估行為,仍需要人類參與。